Chuyện gì đang xảy ra?
Học máy là học từ ví dụ thay vì viết luật bằng tay. Trong học có giám sát (supervised), mỗi ví dụ đi kèm nhãn đúng — ảnh này là mèo, ảnh kia là chó — và mô hình học ánh xạ từ đầu vào sang nhãn. Trong học không giám sát (unsupervised) không có nhãn; ta chỉ tìm cấu trúc trong dữ liệu, ví dụ gom thành cụm bằng k-means hoặc giảm chiều bằng PCA. Thị giác cổ điển ghép hai mảnh: một bộ trích đặc trưng (màu, HOG, túi từ thị giác…) và một bộ phân loại học trên các vector đó.
Bộ phân loại đơn giản nhất là k láng giềng gần nhất (kNN): không “học” gì cả, chỉ nhớ toàn bộ dữ liệu huấn luyện; khi gặp điểm mới thì bỏ phiếu theo k điểm gần nhất. k = 1 cho ranh giới lởm chởm uốn theo từng điểm, kể cả điểm nhiễu; k lớn làm ranh giới mượt nhưng có thể nuốt mất chi tiết thật. kNN rất dễ hiểu, nhưng chậm khi dữ liệu lớn và kém ở không gian nhiều chiều, nơi khái niệm “gần” mất dần ý nghĩa.
Bộ phân loại tuyến tính chia không gian bằng một siêu phẳng w·x + b = 0. Trong vô số siêu phẳng tách được dữ liệu, SVM chọn cái có lề (margin) rộng nhất tới các điểm gần nhất — gọi là vectơ hỗ trợ. Tham số C cân giữa lề rộng và việc chấp nhận vài điểm nằm sai phía. Khi dữ liệu không tách được bằng đường thẳng, mẹo kernel thay tích vô hướng bằng một hàm tương đồng như RBF, tương đương đưa dữ liệu lên không gian nhiều chiều hơn mà không phải tính trực tiếp; gamma lớn làm mỗi điểm chỉ ảnh hưởng một vùng rất hẹp. Cây quyết định thì chia không gian bằng chuỗi câu hỏi kiểu “đặc trưng j có lớn hơn ngưỡng?”, càng sâu càng chi tiết.
Mục tiêu không phải là đúng trên dữ liệu huấn luyện mà là đúng trên dữ liệu mới. Mô hình quá đơn giản thì chưa khớp (underfit, thiên lệch cao): sai cả trên tập huấn luyện. Mô hình quá linh hoạt thì quá khớp (overfit, phương sai cao): thuộc lòng cả nhiễu, điểm huấn luyện gần 100% nhưng điểm kiểm tra tụt. Đó là sự đánh đổi thiên lệch – phương sai. Thêm dữ liệu làm giảm phương sai; tăng độ phức tạp mô hình làm giảm thiên lệch nhưng tăng phương sai.
Vì thế dữ liệu được chia ba phần: train để học, validation để chọn siêu tham số (k, C, gamma, độ sâu), test chỉ dùng một lần ở cuối để báo cáo. Khi dữ liệu ít, kiểm định chéo (cross-validation) xoay vòng phần validation qua k phần để ước lượng ổn định hơn. Định lý “không có bữa trưa miễn phí” nhắc rằng không bộ phân loại nào tốt nhất cho mọi bài toán — mô hình chỉ tốt khi giả định của nó (ranh giới trơn, tách tuyến tính, đặc trưng có ý nghĩa…) hợp với dữ liệu. Trong thực tế, đặc trưng tốt và nhiều dữ liệu thường quan trọng hơn việc chọn bộ phân loại.
Thuật toán không “hiểu” ảnh. Nó chỉ tìm một cách biến đổi có thể kiểm tra được.
Viết lại bằng toán.
Không cần thuộc lòng. Hãy đọc công thức như một câu mô tả: đại lượng nào được cộng, cái gì bị chuẩn hoá, và điều kiện nào khiến nó thất bại.
k láng giềng gần nhất
- N_k(x): k điểm huấn luyện gần x nhất (thường theo khoảng cách Euclid)
- c: một lớp
- 1[·] = 1 khi nhãn trùng
Nên chuẩn hoá đặc trưng trước: một đặc trưng có thang đo lớn sẽ áp đảo khoảng cách.
SVM lề mềm
- y_i ∈ {−1, +1}: nhãn
- Độ rộng lề = 2/‖w‖
- ξ_i: mức vi phạm lề của điểm i
- C: phạt vi phạm — C lớn ép khớp tập huấn luyện chặt hơn
Chỉ các vectơ hỗ trợ (điểm nằm trên hoặc trong lề) quyết định ranh giới.
Nhân RBF
- γ: độ hẹp của ‘vùng ảnh hưởng’ mỗi vectơ hỗ trợ
- α_i ≥ 0: trọng số học được, khác 0 chỉ ở vectơ hỗ trợ
γ nhỏ → ranh giới gần tuyến tính; γ rất lớn → mỗi điểm thành một ‘đảo’ riêng, quá khớp.
Phân rã thiên lệch – phương sai
- Bias: sai lệch trung bình do giả định mô hình quá cứng
- Var: độ dao động của mô hình khi đổi tập huấn luyện
- σ²: nhiễu không thể khử của dữ liệu
Công thức cho sai số bình phương; với phân loại ý tưởng giữ nguyên: đơn giản quá thì lệch, linh hoạt quá thì dao động.
Luồng xử lý bằng lời.
-
01
Biến ảnh thành vector
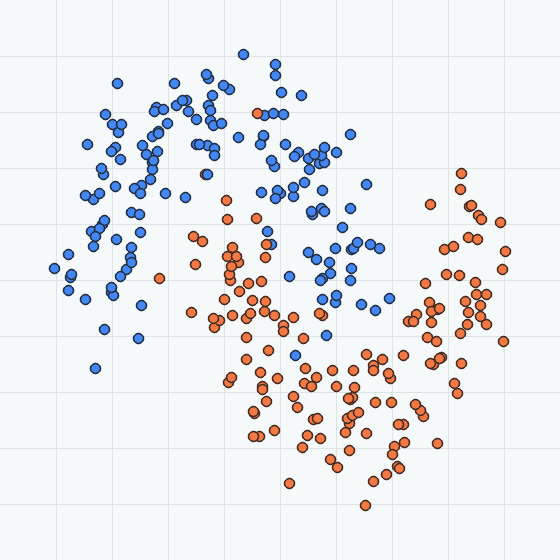
Chọn đặc trưng (histogram màu, HOG, túi từ thị giác, hoặc đặc trưng CNN có sẵn). Ở demo, mỗi điểm 2D chính là vector đặc trưng.
-
02
Chia dữ liệu
train_test_splitgiữ riêng tập test; với phân loại nên dùngstratify=yđể tỉ lệ lớp đều. -
03
Chuẩn hoá
StandardScalertrong mộtPipeline, fit chỉ trên tập train — kNN và SVM nhạy với thang đo. -
04
Chọn siêu tham số
GridSearchCV/cross_val_scorethử k, C, gamma, độ sâu trên các lượt kiểm định chéo. -
05
Đánh giá một lần
So điểm train với test: chênh lớn là dấu hiệu quá khớp; cả hai đều thấp là chưa khớp.
Núm vặn và cạm bẫy.
| Tham số | Ý nghĩa | Khoảng |
|---|---|---|
model | Bộ phân loại: k láng giềng gần nhất, SVM tuyến tính, SVM nhân RBF hoặc cây quyết định. | knn / linear / rbf / tree |
k | Số láng giềng bỏ phiếu (chỉ dùng cho kNN). Nhỏ → ranh giới lởm chởm; lớn → mượt. | 1…25 |
C | Mức phạt vi phạm lề của SVM (tuyến tính và RBF). Lớn → bám tập huấn luyện chặt hơn. | 0.1…20 |
gamma | Độ hẹp của nhân RBF. Lớn → mỗi điểm ảnh hưởng vùng nhỏ, dễ quá khớp. | 0.1…10 |
depth | Độ sâu tối đa của cây quyết định. Sâu → nhiều ô chữ nhật nhỏ, dễ quá khớp. | 1…12 |
noise | Mức nhiễu khi sinh bộ dữ liệu 2D. Nhiễu càng lớn, hai lớp càng chồng lấn và càng dễ thấy quá khớp. | 0…0.5 |
! Cạm bẫy thường gặp
- Chọn siêu tham số bằng tập test rồi báo cáo điểm test đó: con số bị lạc quan, vì test đã gián tiếp tham gia huấn luyện.
- Quên chuẩn hoá đặc trưng cho kNN / SVM, hoặc fit bộ chuẩn hoá trên toàn bộ dữ liệu (rò rỉ thông tin từ test).
- Thấy điểm huấn luyện 100% và tưởng mô hình tốt — với kNN k = 1 hay cây không giới hạn độ sâu, điều đó gần như luôn đúng và chẳng nói lên gì.
- Các ảnh gần trùng nhau (khung hình liên tiếp của một video, cùng một vật chụp nhiều lần) nằm cả ở train lẫn test làm điểm test bị thổi phồng; nên chia theo nhóm.
- Lớp mất cân bằng: độ chính xác 95% có thể chỉ là đoán toàn lớp đông; xem thêm precision, recall, ma trận nhầm lẫn.
Mã nguồn tối giản, không phải giả mã.
import numpy as np
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split, cross_val_score, GridSearchCV
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
from sklearn.tree import DecisionTreeClassifier
from sklearn.cluster import KMeans

X, y = make_moons(n_samples=400, noise=0.2, random_state=0)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, stratify=y, random_state=0)

models = {
    "kNN k=1":        make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=1)),
    "kNN k=15":       make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=15)),
    "SVM tuyến tính": make_pipeline(StandardScaler(), SVC(kernel="linear", C=1.0)),
    "SVM RBF":        make_pipeline(StandardScaler(), SVC(kernel="rbf", C=1.0, gamma=1.0)),
    "SVM RBF γ=50":   make_pipeline(StandardScaler(), SVC(kernel="rbf", C=10.0, gamma=50.0)),
    "Cây sâu 3":      DecisionTreeClassifier(max_depth=3, random_state=0),
    "Cây không giới hạn": DecisionTreeClassifier(random_state=0),
}
for name, m in models.items():
    m.fit(X_tr, y_tr)
    cv = cross_val_score(m, X_tr, y_tr, cv=5).mean()
    print(f"{name:20s} train={m.score(X_tr, y_tr):.2f}  cv={cv:.2f}  test={m.score(X_te, y_te):.2f}")

# Chọn C, gamma bằng kiểm định chéo — chỉ nhìn tập test ở cuối
grid = GridSearchCV(make_pipeline(StandardScaler(), SVC(kernel="rbf")),
                    {"svc__C": [0.1, 1, 10], "svc__gamma": [0.1, 1, 10]}, cv=5)
grid.fit(X_tr, y_tr)
print("tốt nhất:", grid.best_params_, "test =", round(grid.score(X_te, y_te), 3))

# Không giám sát: k-means gom 2 cụm, không dùng nhãn
km = KMeans(n_clusters=2, n_init=10, random_state=0).fit(X)
print("tâm cụm:\n", km.cluster_centers_.round(2))
Điều chỉnh tham số.
Chọn ảnh mẫu hoặc tải ảnh của bạn lên, chỉnh tham số, rồi chạy. Kết quả, các bước trung gian và nhật ký được cập nhật ngay tại đây.
$ bài thử chưa chạy
$ chọn ảnh và bấm “Chạy thử”
Dùng nó ở đâu?
Phân loại ảnh / cảnh từ đặc trưng thủ công (túi từ thị giác + SVM là chuẩn trước thời CNN).
Phát hiện người bằng HOG + SVM tuyến tính trên cửa sổ trượt.
Dùng đặc trưng của mạng học sẵn rồi gắn bộ phân loại nhẹ (kNN, logistic, SVM) khi chỉ có ít ảnh có nhãn.
k-means để xây từ điển thị giác, lượng tử hoá màu, khởi tạo phân đoạn.
Những hướng đang được dùng hiện nay.
Các phương pháp dưới đây không thay thế baseline; chúng giải quyết những điểm yếu của cách cổ điển khi có thêm dữ liệu, GPU hoặc yêu cầu độ ổn định cao hơn.
Đặc trưng học sẵn + đầu tuyến tính (linear probe)
Lấy embedding từ mô hình nền như DINOv2 hoặc CLIP rồi huấn luyện logistic / SVM tuyến tính phía trên — thường mạnh hơn nhiều so với đặc trưng thủ công.
Dùng khi: Ít dữ liệu có nhãn, muốn kết quả nhanh.kNN trên embedding
Truy hồi láng giềng gần nhất trong không gian embedding (thư viện FAISS) cho phân loại, tìm ảnh giống, phát hiện trùng lặp.
Dùng khi: Hàng triệu ảnh, lớp mới thêm liên tục, không muốn huấn luyện lại.Gradient boosting
XGBoost / LightGBM cho đặc trưng dạng bảng (đo đạc hình học, thống kê) — xem chương XGBoost.
Dùng khi: Đặc trưng có ý nghĩa, dữ liệu vừa.- CS 4476 Computer Vision — James Hays, Georgia Tech (bài giảng 17, 18, 19)
- scikit-learn — User Guide (Supervised learning, Model selection)
- Richard Szeliski — Computer Vision: Algorithms and Applications (2nd ed.)
Chương này được viết lại bằng tiếng Việt dựa trên chủ đề của bài giảng gốc; không sao chép slide.