Chuyện gì đang xảy ra?
Phân loại ảnh trả lời “trong ảnh có gì”, còn phát hiện vật thể (object detection) phải trả lời thêm “ở đâu”. Cách đơn giản nhất là biến bài toán khó thành bài toán quen: cắt ra một ô vuông cố định, hỏi bộ phân loại “ô này là vật hay nền?”, rồi trượt ô đó khắp ảnh. Muốn bắt cả vật to lẫn nhỏ, ta không đổi cỡ cửa sổ mà thu nhỏ dần ảnh thành một kim tự tháp tỉ lệ.
Bộ phân loại cần một mô tả bền với ánh sáng nhưng nhạy với hình dạng. HOG (Histogram of Oriented Gradients, Dalal–Triggs 2005) làm việc này: tính gradient ở mỗi điểm ảnh, chia cửa sổ thành các ô nhỏ (cell, thường 8×8), mỗi ô bỏ phiếu hướng gradient vào khoảng 9 ngăn có trọng số theo độ lớn. Sau đó các ô được nhóm thành khối (block) 2×2 chồng lấn và chuẩn hoá độ tương phản theo khối. Kết quả nhìn giống một “bản phác” các nét viền chính của vật.
Trên vector HOG, một SVM tuyến tính là đủ: điểm số chỉ là tích vô hướng với một mẫu trọng số w — tức là một phép tích chập mẫu trên bản đồ HOG, rất nhanh. Khó khăn nằm ở dữ liệu âm: số cửa sổ nền nhiều hơn vật hàng nghìn lần. Mẹo kinh điển là khai thác mẫu âm khó (hard negative mining): huấn luyện lần đầu với nền ngẫu nhiên, chạy bộ dò trên ảnh không có vật, thu các dương tính giả có điểm cao rồi huấn luyện lại.
Một vật thật thường kích hoạt nhiều cửa sổ chồng nhau ở các vị trí và tỉ lệ lân cận. Khử không cực đại (non-maximum suppression, NMS) giữ khung điểm cao nhất và bỏ những khung có IoU với nó vượt ngưỡng. Để đánh giá, một dự đoán được tính là đúng nếu IoU với khung thật ≥ 0,5 (quy ước PASCAL VOC); quét ngưỡng điểm ta có đường precision–recall và diện tích dưới nó là AP.
Cùng thời có nhánh Viola–Jones cho khuôn mặt: đặc trưng Haar tính tức thì bằng ảnh tích phân, AdaBoost chọn vài nghìn đặc trưng tốt nhất, và cascade loại nhanh phần lớn cửa sổ nền ở vài tầng đầu (xem chương Haar / khuôn mặt). Mẫu cứng như HOG hợp với vật ít biến dạng (người đứng, ô tô, mặt); với vật co duỗi như mèo, chó, mô hình bộ phận biến dạng (DPM, Felzenszwalb và cộng sự) gắn thêm các mẫu bộ phận nối lò xo với mẫu gốc — bước đệm trước khi CNN thay thế toàn bộ pipeline.
Thuật toán không “hiểu” ảnh. Nó chỉ tìm một cách biến đổi có thể kiểm tra được.
Viết lại bằng toán.
Không cần thuộc lòng. Hãy đọc công thức như một câu mô tả: đại lượng nào được cộng, cái gì bị chuẩn hoá, và điều kiện nào khiến nó thất bại.
Gradient và phiếu bầu hướng
- g_x, g_y: đạo hàm theo bộ lọc [−1, 0, 1]
- m: trọng số phiếu bầu
- θ: hướng không dấu, chia thành B ngăn (thường 9 ngăn × 20°)
Mỗi phiếu được chia nội suy tuyến tính cho hai ngăn hướng kề nhau (và giữa các ô lân cận) để tránh nhảy bậc khi gradient xoay nhẹ.
Chuẩn hoá theo khối
- v: ghép histogram của 2×2 ô trong một khối (4·B số)
- ε: hằng số nhỏ tránh chia cho 0
Biến thể L2-Hys cắt mọi phần tử ở 0,2 rồi chuẩn hoá lại. Cửa sổ 64×128, ô 8, khối 16 bước 8, 9 ngăn → 7·15 khối × 36 = 3780 chiều.
SVM tuyến tính với hàm mất mát hinge
- x_i: vector HOG của cửa sổ i
- y_i = +1 (vật) hoặc −1 (nền)
- s(x): điểm số; cửa sổ được giữ khi s vượt ngưỡng
Vì s tuyến tính theo HOG, tính điểm mọi cửa sổ tương đương tích chập bản đồ HOG với mẫu w.
IoU, precision và recall
- A, B: khung dự đoán và khung thật
- TP: dự đoán khớp một vật chưa được khớp với IoU ≥ ngưỡng
- AP: diện tích dưới đường P–R khi quét ngưỡng điểm
NMS dùng cùng IoU nhưng giữa các khung dự đoán với nhau: bỏ khung có IoU vượt ngưỡng với khung điểm cao hơn.
Luồng xử lý bằng lời.
-
01
Chuẩn bị mẫu
Cắt mẫu dương cùng tỉ lệ khung, căn giữa, có lề nền mỏng; tăng cường bằng xoay nhẹ, đổi tỉ lệ, lật (nếu vật đối xứng), đổi sáng. Mẫu âm: cửa sổ ngẫu nhiên từ ảnh không có vật.
-
02
Tính HOG
Resize mỗi mẫu về cỡ cửa sổ cố định, tính HOG với cùng cấu hình ô / khối / số hướng sẽ dùng khi chạy thật.
-
03
Huấn luyện + mẫu âm khó
Huấn luyện
LinearSVC; chạy bộ dò trên ảnh nền, gom các cửa sổ có điểm dương (dương tính giả), thêm vào tập âm và huấn luyện lại 1–2 vòng. -
04
Trượt cửa sổ đa tỉ lệ
Với mỗi tầng kim tự tháp (ví dụ thu nhỏ 0,8 lần mỗi tầng), trượt cửa sổ theo bước
stride, chấm điểm, giữ cửa sổ vượt ngưỡng và quy toạ độ về ảnh gốc. -
05
NMS và đánh giá
Sắp khung theo điểm, khử trùng lặp bằng ngưỡng IoU; so với nhãn thật để tính precision–recall và AP.
Núm vặn và cạm bẫy.
| Tham số | Ý nghĩa | Khoảng |
|---|---|---|
view | Chế độ xem: chạy phát hiện (cửa sổ trượt + SVM huấn luyện tại chỗ từ mẫu ngôi sao) hoặc trực quan hoá HOG — mỗi ô vẽ các vạch theo hướng, độ sáng theo độ lớn phiếu. | detect / hog |
cell | Cạnh ô HOG. Ô nhỏ giữ chi tiết nét nhưng vector dài và nhạy nhiễu; ô lớn mô tả hình dạng thô, bền hơn. | 4…16 px, bước 2 |
bins | Số ngăn hướng gradient trong khoảng 0…180°. 9 là giá trị Dalal–Triggs dùng; tăng lên phân biệt hướng mịn hơn nhưng mỗi ngăn ít phiếu hơn. | 6…18 |
stride | Bước trượt cửa sổ. Bước nhỏ ít bỏ sót vật và khung đặt chính xác hơn nhưng số cửa sổ tăng theo bình phương. | 4…32 px, bước 4 |
score | Ngưỡng điểm SVM để giữ một cửa sổ. Thấp: nhiều dương tính giả; cao: bỏ sót vật mờ hoặc lệch dạng. | −1…2, bước 0,05 |
nms | Ngưỡng IoU của NMS: hai khung chồng nhau quá mức này thì bỏ khung điểm thấp. Ngưỡng cao gần như tắt NMS — mỗi vật còn nhiều khung. | 0,1…0,7, bước 0,05 |
! Cạm bẫy thường gặp
- Lấy mẫu âm ngẫu nhiên từ chính ảnh có vật: một số “mẫu âm” chứa vật thật và dạy SVM điều ngược lại. Dùng ảnh nền sạch hoặc loại cửa sổ chồng lên nhãn.
- Cấu hình HOG khi huấn luyện và khi chạy khác nhau (cỡ ô, số hướng, cỡ cửa sổ) — vector lệch chiều hoặc lệch nghĩa, điểm số vô nghĩa.
- Chỉ trượt ở một tỉ lệ: vật to hơn cửa sổ bị bỏ sót hoàn toàn. Cần kim tự tháp tỉ lệ (và nhớ quy toạ độ về ảnh gốc).
- Quên NMS hoặc đặt ngưỡng IoU quá cao: một vật thành hàng chục khung, precision tụt mạnh khi đánh giá.
- Mẫu cứng không chịu được che khuất và biến dạng mạnh; vật xoay tự do (ký hiệu lật ngược) cần thêm mẫu xoay hoặc đặc trưng bất biến xoay.
- So sánh AP giữa hai bài báo dùng ngưỡng IoU khác nhau (0,5 kiểu VOC và trung bình 0,5…0,95 kiểu COCO) là so khập khiễng.
Mã nguồn tối giản, không phải giả mã.
import cv2
import numpy as np
from sklearn.svm import LinearSVC

WIN = 64
# winSize, blockSize, blockStride, cellSize, nbins
hog = cv2.HOGDescriptor((WIN, WIN), (16, 16), (8, 8), (8, 8), 9)
rng = np.random.default_rng(0)


def read_gray(path):
    img = cv2.imread(path, cv2.IMREAD_GRAYSCALE)
    if img is None:
        raise FileNotFoundError(path)
    return img


def feat(patch):
    patch = cv2.resize(patch, (WIN, WIN))
    return hog.compute(np.ascontiguousarray(patch)).ravel()


def augment(tpl, n=300):
    h, w = tpl.shape
    out = []
    for _ in range(n):
        M = cv2.getRotationMatrix2D((w / 2, h / 2), rng.uniform(-15, 15), rng.uniform(0.85, 1.15))
        p = cv2.warpAffine(tpl, M, (w, h), borderMode=cv2.BORDER_REPLICATE).astype(np.float32)
        p = p * rng.uniform(0.7, 1.3) + rng.normal(0, 8, p.shape)
        out.append(feat(np.clip(p, 0, 255).astype(np.uint8)))
    return out


def random_windows(img, n):
    H, W = img.shape
    out = []
    for _ in range(n):
        s = int(rng.integers(32, min(H, W, 160)))
        y, x = int(rng.integers(0, H - s)), int(rng.integers(0, W - s))
        out.append(feat(img[y:y + s, x:x + s]))
    return out


def detect(img, clf, stride=8, thresh=0.3, scales=(1.0, 0.8, 0.64, 0.5)):
    boxes, scores = [], []
    for s in scales:
        im = cv2.resize(img, None, fx=s, fy=s)
        if min(im.shape) < WIN:
            break
        coords, feats = [], []
        for y in range(0, im.shape[0] - WIN + 1, stride):
            for x in range(0, im.shape[1] - WIN + 1, stride):
                coords.append((x, y))
                feats.append(hog.compute(np.ascontiguousarray(im[y:y + WIN, x:x + WIN])).ravel())
        sc = clf.decision_function(np.array(feats))
        for (x, y), v in zip(coords, sc):
            if v > thresh:   # quy toạ độ về ảnh gốc
                boxes.append([int(x / s), int(y / s), int(WIN / s), int(WIN / s)])
                scores.append(float(v))
    return boxes, scores


tpl = read_gray("star_template.jpg")
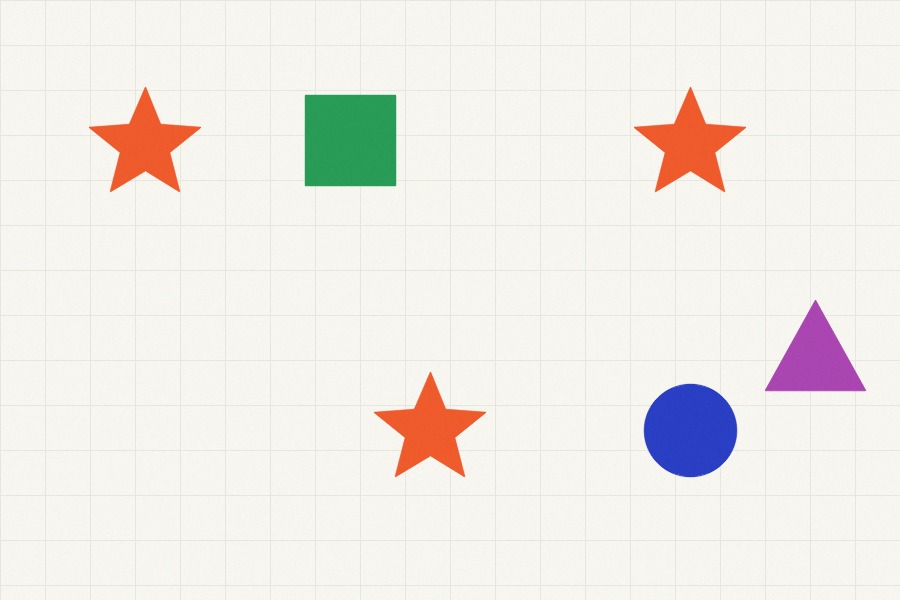
scene = read_gray("symbols_scene.jpg")
background = read_gray("road.jpg")        # ảnh KHÔNG có ngôi sao -> nguồn mẫu âm

pos = augment(tpl)
neg = random_windows(background, 1000)
X = np.array(pos + neg)
y = np.array([1] * len(pos) + [0] * len(neg))
clf = LinearSVC(C=0.01, max_iter=5000).fit(X, y)

# Khai thác mẫu âm khó: dương tính giả trên ảnh nền -> thêm vào tập âm
fp_boxes, _ = detect(background, clf, stride=16, thresh=0.0)
hard = [feat(background[b[1]:b[1] + b[3], b[0]:b[0] + b[2]]) for b in fp_boxes[:500]]
if hard:
    X = np.vstack([X, hard])
    y = np.concatenate([y, np.zeros(len(hard), int)])
    clf = LinearSVC(C=0.01, max_iter=5000).fit(X, y)

boxes, scores = detect(scene, clf, stride=8, thresh=0.3)
keep = cv2.dnn.NMSBoxes(boxes, scores, 0.3, 0.3) if boxes else []
out = cv2.cvtColor(scene, cv2.COLOR_GRAY2BGR)
for i in np.array(keep).flatten():
    x, y0, w, h = boxes[i]
    cv2.rectangle(out, (x, y0), (x + w, y0 + h), (0, 0, 255), 2)
print(len(boxes), "cửa sổ vượt ngưỡng ->", len(keep), "khung sau NMS")
cv2.imwrite("detections.jpg", out)
Điều chỉnh tham số.
Chọn ảnh mẫu hoặc tải ảnh của bạn lên, chỉnh tham số, rồi chạy. Kết quả, các bước trung gian và nhật ký được cập nhật ngay tại đây.
$ bài thử chưa chạy
$ chọn ảnh và bấm “Chạy thử”
Dùng nó ở đâu?
Phát hiện người đi bộ trong camera giám sát và hệ thống hỗ trợ lái (bài toán gốc của Dalal–Triggs).
Phát hiện khuôn mặt, ô tô, biển báo khi không có GPU — HOG + SVM chạy nhanh trên CPU (dlib, OpenCV).
Tìm ký hiệu, logo, linh kiện có hình dạng cố định trên bản vẽ hoặc dây chuyền.
Bước tạo đề xuất hoặc đặc trưng nền tảng để hiểu các detector CNN như R-CNN, YOLO, DETR.
Những hướng đang được dùng hiện nay.
Các phương pháp dưới đây không thay thế baseline; chúng giải quyết những điểm yếu của cách cổ điển khi có thêm dữ liệu, GPU hoặc yêu cầu độ ổn định cao hơn.
Detector CNN một giai đoạn (YOLO, SSD)
Thay cửa sổ trượt bằng lưới dự đoán dày đặc trên bản đồ đặc trưng học được; vẫn dùng NMS và IoU như cũ.
Dùng khi: Phát hiện thời gian thực nhiều lớp.DETR và detector không cần NMS
Transformer dự đoán trực tiếp một tập khung, ghép với nhãn bằng thuật toán Hungarian khi huấn luyện.
Dùng khi: Pipeline gọn, ít thủ thuật hậu xử lý.- CS 4476 Computer Vision — James Hays, Georgia Tech (bài giảng 23, 24, 25)
- Dalal & Triggs — Histograms of Oriented Gradients for Human Detection (CVPR 2005)
- Richard Szeliski — Computer Vision: Algorithms and Applications (2nd ed.)
Chương này được viết lại bằng tiếng Việt dựa trên chủ đề của bài giảng gốc; không sao chép slide.