Chuyện gì đang xảy ra?
Mô hình phân biệt (discriminative) trả lời "ảnh này là gì?" — học p(nhãn | ảnh). Mô hình sinh (generative) đi theo chiều ngược: học chính phân bố của dữ liệu để tạo ra mẫu mới trông như thật. Khó ở chỗ ta không viết được công thức "thế nào là một khuôn mặt thật"; mọi hàm mất mát đo theo pixel như L2 đều thưởng cho kết quả nhoè, trung bình của mọi khả năng.
Bài toán tô màu ảnh xám minh hoạ rõ cái bẫy đó. Một quả táo trong ảnh xám có thể đỏ, xanh hay vàng; hồi quy L2 sẽ chọn màu trung bình — một màu nâu xám nhạt nhẽo. Zhang, Isola và Efros giải bằng cách chia không gian ab thành 313 ô và coi tô màu là phân loại với cân bằng lại lớp hiếm, rồi đánh giá bằng cách hỏi người xem trên Mechanical Turk "ảnh nào là thật?". GAN tự động hoá chính câu hỏi đó: thay người xem bằng một mạng.
GAN (Goodfellow et al. 2014) gồm hai mạng. Bộ sinh G nhận vector nhiễu z và trả về một mẫu G(z). Bộ phân biệt D nhận một mẫu và đoán xác suất nó đến từ dữ liệu thật. D được huấn luyện để bắt giả giỏi hơn; G được huấn luyện để lừa D. Khi cân bằng lý tưởng, phân bố của G trùng phân bố thật và D chỉ còn đoán bừa 50/50.
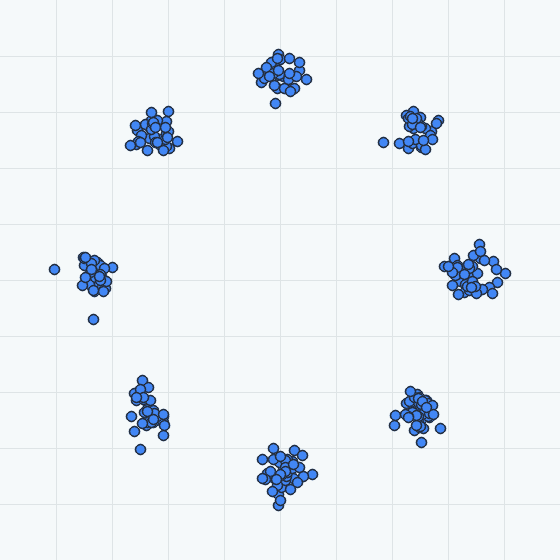
Thực tế hiếm khi lý tưởng. Nếu D quá mạnh, gradient về G gần như bằng 0 và G không học được gì. Nếu G tìm được một vài mẫu lừa được D, nó có thể chỉ sinh đúng mấy mẫu đó — sụp mode (mode collapse): bộ dữ liệu có 8 cụm mà G chỉ phủ 2–3 cụm. Huấn luyện là hai bên cùng chạy, không có một hàm mất mát duy nhất giảm dần để theo dõi.
Bài thử dùng một GAN rất nhỏ viết bằng NumPy, học phân bố điểm 2D (vòng tròn 8 cụm hoặc hai trăng) — đủ nhỏ để nhìn tận mắt mẫu sinh ra di chuyển qua các bước và vùng D cho là "thật". Trên ảnh, DCGAN đưa ra các nguyên tắc kiến trúc tích chập giúp huấn luyện ổn định hơn; GAN có điều kiện như pix2pix (ảnh → ảnh với cặp dữ liệu) và CycleGAN (không cần cặp, dùng ràng buộc vòng) mở ra hàng loạt ứng dụng dịch ảnh.
Thuật toán không “hiểu” ảnh. Nó chỉ tìm một cách biến đổi có thể kiểm tra được.
Viết lại bằng toán.
Không cần thuộc lòng. Hãy đọc công thức như một câu mô tả: đại lượng nào được cộng, cái gì bị chuẩn hoá, và điều kiện nào khiến nó thất bại.
Trò chơi minimax
- D(x) ∈ (0,1): xác suất D cho rằng x là thật
- p_z: phân bố nhiễu đơn giản (Gauss hoặc đều)
- D muốn V lớn (phân loại đúng); G muốn V nhỏ (lừa được D)
Đây chính là cross-entropy nhị phân của D với nhãn thật = 1, giả = 0.
Bộ phân biệt tối ưu
- p_g: phân bố của các mẫu G(z)
- JSD: khoảng cách Jensen–Shannon, bằng 0 khi và chỉ khi p_g = p_data
Với D tối ưu, G đang tối thiểu hoá JSD; khi hai phân bố gần như không chồng nhau, JSD bão hoà và gradient biến mất — một nguồn gốc của sự khó huấn luyện.
Mất mát không bão hoà cho G
- Thay vì tối thiểu log(1 − D(G(z))), G tối đa log D(G(z))
- Cùng điểm cân bằng nhưng gradient mạnh khi D đang thắng dễ
Đây là dạng gần như mọi mã GAN dùng trong thực tế (BCE với nhãn "thật" cho mẫu giả khi cập nhật G).
Ràng buộc vòng (CycleGAN) & FID
- G: X → Y, F: Y → X — đi rồi về phải quay lại ảnh cũ
- μ, Σ: trung bình và hiệp phương sai đặc trưng Inception của ảnh thật (r) và ảnh sinh (g)
FID càng thấp càng tốt; nó nhạy với cả chất lượng lẫn độ đa dạng, nhưng phụ thuộc số mẫu và mạng đặc trưng nên chỉ so được trong cùng một quy trình đo.
Luồng xử lý bằng lời.
-
01
Chuẩn bị dữ liệu & nhiễu
Chuẩn hoá dữ liệu thật về khoảng nhỏ (ảnh về [−1, 1] nếu G kết thúc bằng tanh). Chọn chiều nhiễu z (2 cho bài 2D, 100–512 cho ảnh).
-
02
Dựng G và D
G: nhiễu → mẫu (MLP cho điểm 2D, tích chập chuyển vị cho ảnh). D: mẫu → một logit. DCGAN gợi ý: bỏ pooling, dùng stride, BatchNorm, LeakyReLU trong D.
-
03
Cập nhật D
Lấy một lô thật và một lô giả G(z) (cắt gradient về G), tối thiểu BCE với nhãn 1 cho thật, 0 cho giả. Có thể lặp k bước D cho mỗi bước G.
-
04
Cập nhật G
Sinh lô giả mới, đưa qua D, tối thiểu −log D(G(z)) (mất mát không bão hoà). Chỉ cập nhật trọng số G.
-
05
Theo dõi & đánh giá
Đừng tin vào đường loss; hãy xem mẫu sinh theo thời gian, đếm mode được phủ (bài 2D) hoặc đo FID trên tập ảnh. Lưu nhiều checkpoint vì chất lượng có thể dao động.
Núm vặn và cạm bẫy.
| Tham số | Ý nghĩa | Khoảng |
|---|---|---|
steps | Số vòng huấn luyện (mỗi vòng = d_steps lần cập nhật D + 1 lần cập nhật G). Ít bước thì mẫu sinh còn là một đám lộn xộn. | 100…3000, bước 100 |
lr | Tốc độ học dùng chung cho G và D. Quá lớn → dao động, xoay vòng quanh các cụm; quá nhỏ → hội tụ chậm. | 0.0005…0.01 |
d_steps | Số bước cập nhật D cho mỗi bước G. Tăng để D theo kịp G; quá nhiều thì D thắng áp đảo và gradient về G yếu đi. | 1…5 |
seed | Hạt giống khởi tạo trọng số và nhiễu. Cùng cấu hình nhưng khác hạt giống có thể cho kết quả phủ đủ hoặc sụp mode — cho thấy GAN nhạy với khởi tạo. | 0…20 |
! Cạm bẫy thường gặp
- Theo dõi đường loss như mạng thường: loss của G và D dao động theo nhau, giảm không có nghĩa là tốt lên. Phải xem mẫu sinh và đo chỉ số như FID.
- Sụp mode: G chỉ sinh vài kiểu mẫu. Dấu hiệu là mẫu từ các z khác nhau giống hệt nhau; thử nhiều seed, minibatch discrimination, hoặc chuyển sang WGAN-GP.
- D quá mạnh (học quá nhanh, quá nhiều bước) làm gradient về G biến mất; D quá yếu thì G lừa dễ và không cải thiện. Cân bằng lr và d_steps.
- Quên detach mẫu giả khi cập nhật D, hoặc vô tình cập nhật D khi bước G — gradient đi sai mạng, huấn luyện hỏng âm thầm.
- Dùng FID với quá ít mẫu hoặc so FID giữa hai bài báo đo khác cách: con số không so sánh được.
- Ảnh sinh trông thật không có nghĩa là đúng: pix2pix / CycleGAN có thể "bịa" chi tiết (khối u trong ảnh y tế, chữ trên biển) — nguy hiểm ở ứng dụng cần trung thực.
Mã nguồn tối giản, không phải giả mã.
# Minh hoạ bằng PyTorch (pip install torch). GAN nhỏ học vòng tròn 8 cụm Gauss trong mặt phẳng.
import math

import torch
import torch.nn as nn

torch.manual_seed(3)


def sample_ring(n, k=8, radius=2.0, std=0.05):
    idx = torch.randint(0, k, (n,))
    ang = idx.float() * 2 * math.pi / k
    centers = torch.stack([radius * torch.cos(ang), radius * torch.sin(ang)], dim=1)
    return centers + std * torch.randn(n, 2)


def mlp(n_in, n_out, h=128):
    return nn.Sequential(nn.Linear(n_in, h), nn.ReLU(),
                         nn.Linear(h, h), nn.ReLU(),
                         nn.Linear(h, n_out))


Z = 2
G = mlp(Z, 2)          # nhiễu -> điểm 2D
D = mlp(2, 1)          # điểm 2D -> logit "thật"
opt_g = torch.optim.Adam(G.parameters(), lr=2e-3, betas=(0.5, 0.999))
opt_d = torch.optim.Adam(D.parameters(), lr=2e-3, betas=(0.5, 0.999))
bce = nn.BCEWithLogitsLoss()

steps, d_steps, batch = 1500, 1, 256
ones, zeros = torch.ones(batch, 1), torch.zeros(batch, 1)

for step in range(steps):
    for _ in range(d_steps):
        real = sample_ring(batch)
        fake = G(torch.randn(batch, Z)).detach()      # không lan gradient về G
        loss_d = bce(D(real), ones) + bce(D(fake), zeros)
        opt_d.zero_grad()
        loss_d.backward()
        opt_d.step()

    fake = G(torch.randn(batch, Z))
    loss_g = bce(D(fake), ones)                       # mất mát không bão hoà
    opt_g.zero_grad()
    loss_g.backward()
    opt_g.step()

    if step % 300 == 0:
        print(f"bước {step:4d}  loss_D={loss_d.item():.3f}  loss_G={loss_g.item():.3f}")

# Đếm số cụm được phủ để phát hiện sụp mode
with torch.no_grad():
    s = G(torch.randn(4000, Z))
    ang = torch.atan2(s[:, 1], s[:, 0])
    mode = torch.round(ang / (2 * math.pi / 8)).long() % 8
    near = (s.norm(dim=1) - 2.0).abs() < 0.3
    covered = len(set(mode[near].tolist()))
    print(f"Số cụm được phủ: {covered} / 8   (tỉ lệ mẫu nằm gần vòng: {near.float().mean():.2f})")
Điều chỉnh tham số.
Chọn ảnh mẫu hoặc tải ảnh của bạn lên, chỉnh tham số, rồi chạy. Kết quả, các bước trung gian và nhật ký được cập nhật ngay tại đây.
$ bài thử chưa chạy
$ chọn ảnh và bấm “Chạy thử”
Dùng nó ở đâu?
Dịch ảnh sang ảnh: bản đồ ↔ ảnh vệ tinh, phác thảo → ảnh, ngày → đêm (pix2pix, CycleGAN).
Siêu phân giải và khử nhiễu cho ra chi tiết sắc nét hơn hồi quy L2 (mất mát đối kháng + mất mát cảm nhận).
Sinh dữ liệu tổng hợp để tăng cường huấn luyện khi dữ liệu thật hiếm.
Tô màu ảnh xám, phục chế ảnh cũ, chỉnh sửa khuôn mặt trong không gian ẩn.
Những hướng đang được dùng hiện nay.
Các phương pháp dưới đây không thay thế baseline; chúng giải quyết những điểm yếu của cách cổ điển khi có thêm dữ liệu, GPU hoặc yêu cầu độ ổn định cao hơn.
WGAN / WGAN-GP
Thay JSD bằng khoảng cách Wasserstein và ép D (critic) thoả điều kiện Lipschitz bằng phạt gradient; loss có ý nghĩa hơn và huấn luyện ổn định hơn.
Dùng khi: GAN cơ bản hay sụp mode hoặc không hội tụ.StyleGAN (Karras et al.)
Bộ sinh ánh xạ z sang không gian kiểu w rồi điều khiển từng tầng bằng phép chuẩn hoá kiểu AdaIN; cho khuôn mặt độ phân giải cao và không gian ẩn dễ chỉnh sửa.
Dùng khi: Sinh / chỉnh sửa ảnh một miền hẹp chất lượng cao (mặt người, xe, phòng).Mô hình khuếch tán (DDPM, Stable Diffusion)
Học khử nhiễu dần từ nhiễu thuần về ảnh; huấn luyện ổn định, phủ mode tốt hơn GAN, điều kiện bằng văn bản dễ. Đổi lại sinh chậm hơn vì cần nhiều bước.
Dùng khi: Sinh ảnh đa dạng theo mô tả văn bản; hiện là lựa chọn mặc định cho sinh ảnh tổng quát.GAN như mất mát phụ
Mất mát đối kháng vẫn được dùng làm thành phần trong bộ mã hoá ảnh (tokenizer, VAE của mô hình khuếch tán), siêu phân giải và chưng cất mô hình khuếch tán để sinh ít bước.
Dùng khi: Cần ảnh sắc nét trong một hệ thống đã có mất mát tái tạo.- CS 4476 Computer Vision — James Hays, Georgia Tech (bài giảng 37, 38)
- Goodfellow et al. — Generative Adversarial Nets (NeurIPS 2014)
- Isola, Zhu, Zhou, Efros — Image-to-Image Translation with Conditional Adversarial Networks (pix2pix)
Chương này được viết lại bằng tiếng Việt dựa trên chủ đề của bài giảng gốc; không sao chép slide.